Redis HyperLogLog用户统计功能实现方式代码实用指南
2026-10-25 3468249
2026-10-25 0
与大语言模型交互并不只是写下一句问题。提示的结构、采样参数和示例数量都会改变生成结果,而输入文本还需要先经过分词器转换为词元序列。要稳定地使用模型或构建智能体,就需要同时理解提示设计、输出采样与 Tokenization 这三项基础机制。
如果我们把大语言模型比作一个能力极强的“大脑”,那么提示 (Prompt) 就是我们与这个“大脑”沟通的语言。提示工程,就是研究如何设计出精准的提示,从而引导模型产生我们期望输出的回复。对于构建智能体而言,一个精心设计的提示能让智能体之间协作分工变得高效。
在使用大模型时,你会经常看到类似Temperature这类的可配置参数,其本质是通过调整模型对 “概率分布” 的采样策略,让输出匹配具体场景需求,配置合适的参数可以提升Agent在特定场景的性能。
传统的概率分布是由 Softmax 公式计算得到的:p_i = \frac{e^{z_i}}{\sum_{j=1}^k e^{z_j}}pi=∑j=1kezjezi,采样参数的本质就是在此基础上,根据不同策略“重新调整”或“截断”分布,从而改变大模型输出的下一个token。
Temperature:温度是控制模型输出 “随机性” 与 “确定性” 的关键参数。其原理是引入温度系数T\gt0T>0,将 Softmax 改写为p_i^{(T)} = \frac{e^{z_i / T}}{\sum_{j=1}^k e^{z_j / T}}pi(T)=∑j=1kezj/Tezi/T。
当T变小时,分布“更加陡峭”,高概率项权重进一步放大,生成更“保守”且重复率更高的文本。当T变大时,分布“更加平坦”,低概率项权重提升,生成更“多样”但可能出现不连贯的内容。
Top-k :其原理是将所有 token 按概率从高到低排序,取排名前 k 个的 token 组成 “候选集”,随后对筛选出的 k 个 token 的概率进行 “归一化”: \hat{p}i = \frac{p_i}{\sum{j \in \text{候选集}} p_j}p^i=∑j∈候选集pjpi
Top-p :其原理是将所有 token 按概率从高到低排序,从排序后的第一个 token 开始,逐步累加概率,直到累积和首次达到或超过阈值 p: \sum_{i \in S} p_{(i)} \geq p∑i∈Sp(i)≥p,此时累加过程中包含的所有 token 组成 “核集合”,最后对核集合进行归一化。
在文本生成中,当同时设置 Top-p、Top-k 和温度系数时,这些参数会按照分层过滤的方式协同工作,其优先级顺序为:温度调整→Top-k→Top-p。温度调整整体分布的陡峭程度,Top-k 会先保留概率最高的 k 个候选,然后 Top-p 会从 Top-k 的结果中选取累积概率≥p 的最小集合作为最终的候选集。不过,通常 Top-k 和 Top-p 二选一即可,若同时设置,实际候选集为两者的交集。 需要注意的是,如果将温度设置为 0,则 Top-k 和 Top-p 将变得无关紧要,因为最有可能的 Token 将成为下一个预测的 Token;如果将 Top-k 设置为 1,温度和 Top-p 也将变得无关紧要,因为只有一个 Token 通过 Top-k 标准,它将是下一个预测的 Token。
根据我们给模型提供示例(Exemplar)的数量,提示可以分为三种类型。为了更好地理解它们,让我们以一个情感分类任务为例,目标是让模型判断一段文本的情感色彩(如正面、负面或中性)。
零样本提示 (Zero-shot Prompting) 这指的是我们不给模型任何示例,直接让它根据指令完成任务。这得益于模型在海量数据上预训练后获得的强大泛化能力。
案例: 我们直接向模型下达指令,要求它完成情感分类任务。
文本:Datawhale的AI Agent课程非常棒!
情感:正面Copy to clipboardErrorCopied
单样本提示 (One-shot Prompting) 我们给模型提供一个完整的示例,向它展示任务的格式和期望的输出风格。
案例: 我们先给模型一个完整的“问题-答案”对作为示范,然后提出我们的新问题。
文本:这家餐厅的服务太慢了。
情感:负面

文本:Datawhale的AI Agent课程非常棒!
情感:Copy to clipboardErrorCopied
模型会模仿给出的示例格式,为第二段文本补全“正面”。
少样本提示 (Few-shot Prompting) 我们提供多个示例,这能让模型更准确地理解任务的细节、边界和细微差别,从而获得更好的性能。
案例: 我们提供涵盖了不同情况的多个示例,让模型对任务有更全面的理解。
文本:这家餐厅的服务太慢了。
情感:负面

文本:这部电影的情节很平淡。
情感:中性

文本:Datawhale的AI Agent课程非常棒!
情感:Copy to clipboardErrorCopied
模型会综合所有示例,更准确地将最后一句的情感分类为“正面”。
早期的 GPT 模型(如 GPT-3)主要是“文本补全”模型,它们擅长根据前面的文本续写,但不一定能很好地理解并执行人类的指令。
指令调优 (Instruction Tuning) 是一种微调技术,它使用大量“指令-回答”格式的数据对预训练模型进行进一步的训练。经过指令调优后,模型能更好地理解并遵循用户的指令。我们今天日常工作学习中使用的所有模型(如 ChatGPT, DeepSeek, Qwen)都是其模型家族中经过指令调优过的模型。
这是一段将英文翻译成中文的程序。
英文:Hello
中文:你好
英文:How are you?
中文:Copy to clipboardErrorCopied
请将下面的英文翻译成中文:
How are you?Copy to clipboardErrorCopied
指令调优的出现,极大地简化了我们与模型交互的方式,使得直接、清晰的自然语言指令成为可能。
角色扮演 (Role-playing) 通过赋予模型一个特定的角色,我们可以引导它的回答风格、语气和知识范围,使其输出更符合特定场景的需求。
# 案例
你现在是一位资深的Python编程专家。请解释一下Python中的GIL(全局解释器锁)是什么,要让一个初学者也能听懂。Copy to clipboardErrorCopied
上下文示例 (In-context Example) 这与少样本提示的思想一致,通过在提示中提供清晰的输入输出示例,来“教会”模型如何处理我们的请求,尤其是在处理复杂格式或特定风格的任务时非常有效。
# 案例
我需要你从产品评论中提取产品名称和用户情感。请严格按照下面的JSON格式输出。

评论:这款“星尘”笔记本电脑的屏幕显示效果惊人,但我不太喜欢它的键盘手感。
输出:{"product_name": "星尘笔记本电脑", "sentiment": "混合"}

评论:我刚买的“声动”耳机音质很棒,续航也超出了我的预期!
输出:
(5)思维链 对于需要逻辑推理、计算或多步骤思考的复杂问题,直接让模型给出答案往往容易出错。思维链 (Chain-of-Thought, CoT) 是一种强大的提示技巧,它通过引导模型“一步一步地思考”,提升了模型在复杂任务上的推理能力。
实现 CoT 的关键,是在提示中加入一句简单的引导语,如“请逐步思考”或“Let's think step by step”。
# 思维链提示
一个篮球队在一个赛季的80场比赛中赢了60%。在接下来的赛季中,他们打了15场比赛,赢了12场。两个赛季的总胜率是多少?
请一步一步地思考并解答。

>>>
(模型可能会输出)
好的,我们来一步步计算。
第一步:计算第一个赛季赢得的比赛数。
80场 * 60% = 48场。
第二步:计算两个赛季的总比赛数和总胜利数。
总比赛数 = 80 + 15 = 95场。
总胜利数 = 48 + 12 = 60场。
第三步:计算总胜率。
总胜率 = (总胜利数 / 总比赛数) * 100% = (60 / 95) * 100% ≈ 63.16%。
所以,两个赛季的总胜率约为63.16%。Copy to clipboardErrorCopied
通过显式地展示其推理过程,模型不仅更容易得出正确的答案,也让它的回答变得更可信、更易于我们检查和纠正。
我们知道,计算机本质上只能理解数字。因此,在将自然语言文本喂给大语言模型之前,必须先将其转换成模型能够处理的数字格式。这个将文本序列转换为数字序列的过程,就叫做分词 (Tokenization) 。分词器 (Tokenizer) 的作用,就是定义一套规则,将原始文本切分成一个个最小的单元,我们称之为词元 (Token) 。
早期的自然语言处理任务可能会采用简单的分词策略:
按词分词 (Word-based) :直接用空格或标点符号将句子切分成单词。这种方法很直观,但也面临挑战:
按字符分词 (Character-based) :将文本切分成单个字符。这种方法词表很小(例如英文字母、数字和标点),不存在 OOV 问题。但它的缺点是,单个字符大多不具备独立的语义,模型需要花费更多的精力去学习如何将字符组合成有意义的词,导致学习效率低下。
为了兼顾词表大小和语义表达,现代大语言模型普遍采用子词分词 (Subword Tokenization) 算法。它的核心思想是:将常见的词(如 "agent")保留为完整的词元,同时将不常见的词(如 "Tokenization")拆分成多个有意义的子词片段(如 "Token" 和 "ization")。这样既控制了词表的大小,又能让模型通过组合子词来理解和生成新词。
字节对编码 (Byte-Pair Encoding, BPE) 是最主流的子词分词算法之一[6],GPT系列模型就采用了这种算法。其核心思想非常简洁,可以理解为一个“贪心”的合并过程:
案例演示: 假设我们的迷你语料库是 {"hug": 1, "pug": 1, "pun": 1, "bun": 1},并且我们想构建一个大小为 10 的词表。BPE 的训练过程可以用下表3.1来表示:
表 3.1 BPE 算法合并过程示例
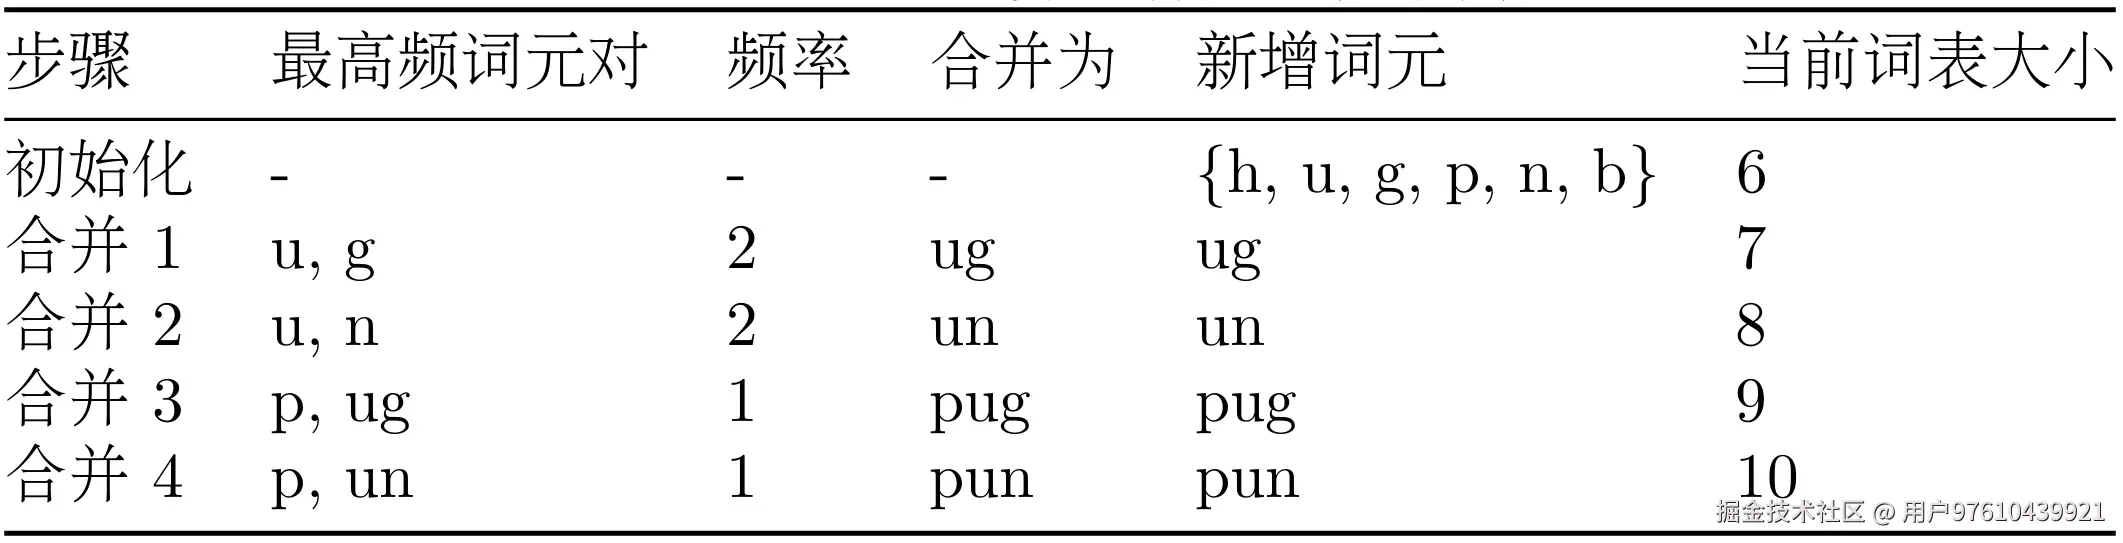
训练结束后,词表大小达到 10,我们就得到了新的分词规则。现在,对于一个未见过的词 "bug",分词器会先查找 "bug" 是否在词表中,发现不在;然后查找 "bu",发现不在;最后查找 "b" 和 "ug",发现都在,于是将其切分为 ['b', 'ug']。
下面我们用一段简单的 Python 代码来模拟上述过程:
import re, collections

def get_stats(vocab):
    """统计词元对频率"""
    pairs = collections.defaultdict(int)
    for word, freq in vocab.items():
        symbols = word.split()
        for i in range(len(symbols)-1):
            pairs[symbols[i],symbols[i+1]] += freq
    return pairs

def merge_vocab(pair, v_in):
    """合并词元对"""
    v_out = {}
    bigram = re.escape(' '.join(pair))
    p = re.compile(r'(?表示结束,并切分好字符
vocab = {'h u g ': 1, 'p u g ': 1, 'p u n ': 1, 'b u n ': 1}
num_merges = 4 # 设置合并次数

for i in range(num_merges):
    pairs = get_stats(vocab)
    if not pairs:
        break
    best = max(pairs, key=pairs.get)
    vocab = merge_vocab(best, vocab)
    print(f"第{i+1}次合并: {best} -> {''.join(best)}")
    print(f"新词表(部分): {list(vocab.keys())}")
    print("-" * 20)

>>>
第1次合并: ('u', 'g') -> ug
新词表(部分): ['h ug ', 'p ug ', 'p u n ', 'b u n ']
--------------------
第2次合并: ('ug', '') -> ug
新词表(部分): ['h ug', 'p ug', 'p u n ', 'b u n ']
--------------------
第3次合并: ('u', 'n') -> un
新词表(部分): ['h ug', 'p ug', 'p un ', 'b un ']
--------------------
第4次合并: ('un', '') -> un
新词表(部分): ['h ug', 'p ug', 'p un', 'b un']
--------------------Copy to clipboardErrorCopied
这段代码清晰地展示了 BPE 算法如何通过迭代合并最高频的相邻词元对,来逐步构建和扩充词表的过程。
后续的许多算法都是在BPE的基础上进行优化的。其中,Google 开发的 WordPiece 和 SentencePiece 是影响力最大的两种。
_ 表示)。这使得分词和解码过程完全可逆,且不依赖于特定的语言(例如,它不需要知道中文不使用空格分词)。理解分词算法的细节并非目的,但作为智能体的开发者,理解分词器的实际影响十分重要,这直接关系到智能体的性能、成本和稳定性:
2 + 2,但对于 2+2(没有空格)就可能出错,因为后者可能被分词器视为一个独立的、不常见的词元。同样,一个词因为首字母大小写不同,也可能被切分成完全不同的 Token 序列,从而影响模型的理解。在设计提示词和解析模型输出时,考虑到这些“陷阱”有助于提升智能体的鲁棒性。