权重可读可写,模型安全会有什么新风险?版本完整性和运行控制
2026-11-06 3469112

2026-11-06 0
通用模型直接参与分析并修改另一网络的参数,确实扩展了 AI 优化模型的方式。但它与不受约束的自我改进不同,实验中的任务、工具、修改对象和预算仍然受控。
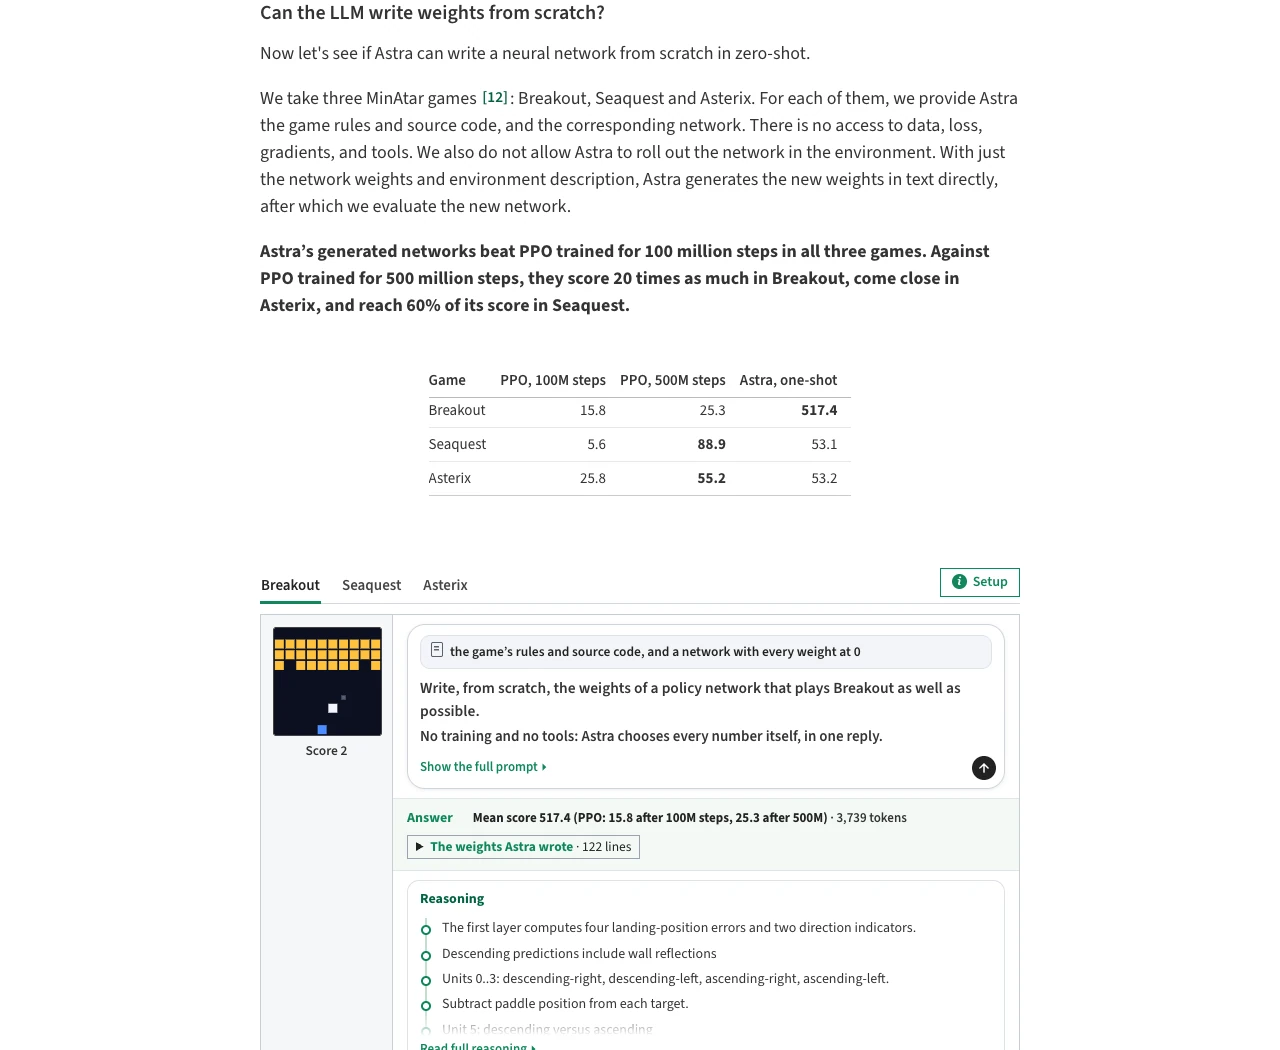
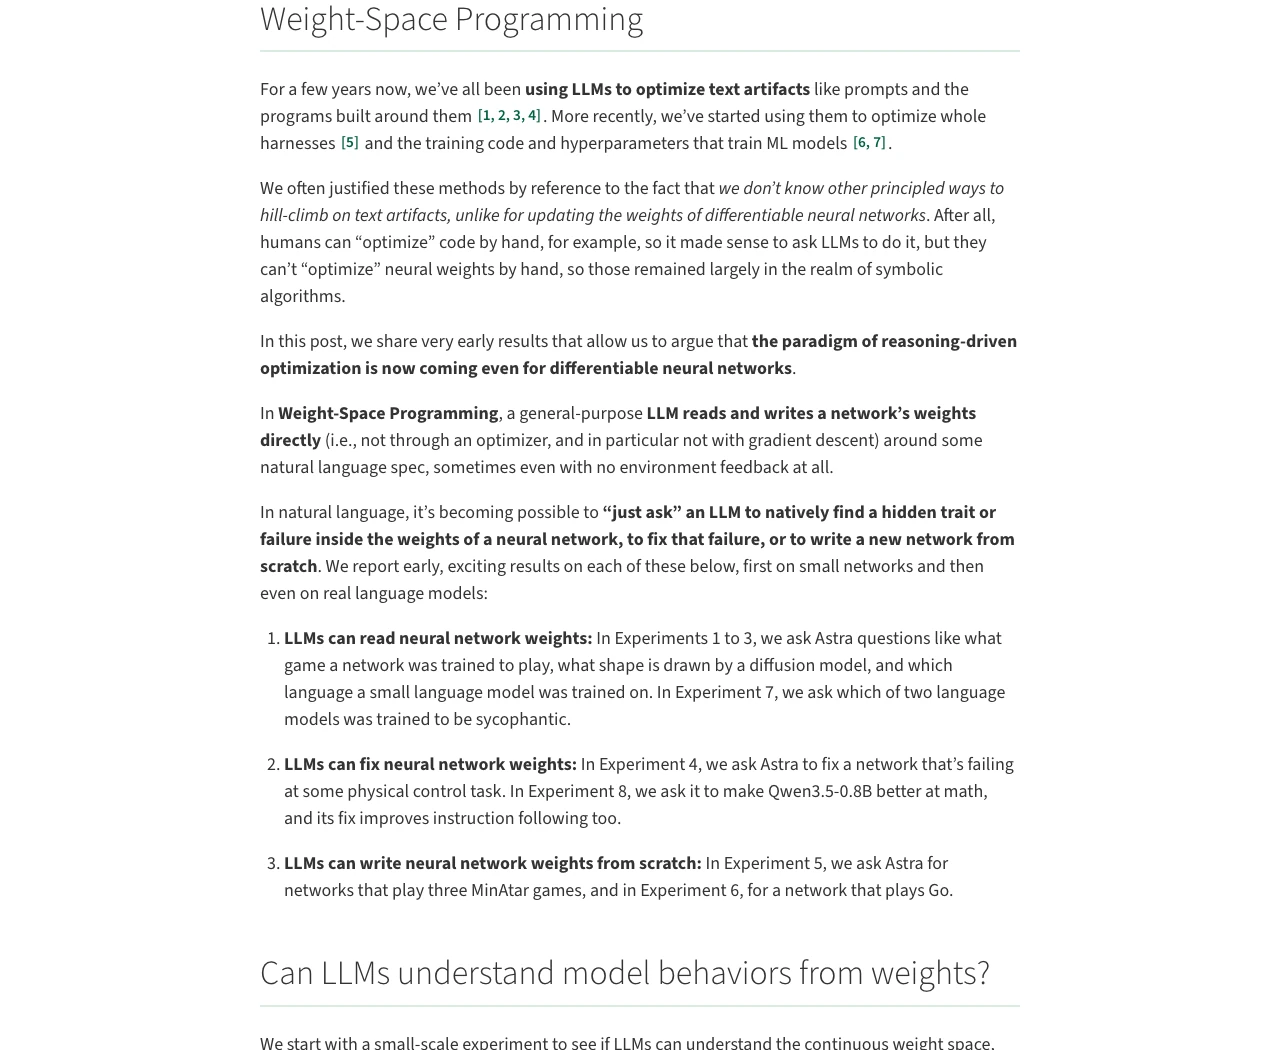
过去常见做法是让 AI 改提示、写评测、生成训练数据或调整训练代码。权重空间编程把目标推进到参数本身:模型需考虑某个部分怎样计算,再写入修改。有没有使用 Python,不是区分两者的关键。
实验中 Astra 与被编辑的 Qwen 是不同模型,任务、工具和预算也由研究者设定。Astra 没有因为修改了 Qwen,就自动把自己的基础权重更新。教师帮助学生修复问题,与教师递归改进自己是不同命题。
即使未来尝试自我编辑,也需证明修改能安全部署、持续改善,并通过独立评价,不能只根据一次成功推断无限进步。
研究者选择模型与任务,搭建张量工具、规定允许的操作、准备练习和评测,并解释结果。小网络实验还有规则与源码输入。这些设计是方法的一部分,不应在传播中全部删掉。
结果可能提示自动化潜力,但不等于人类研究、数据与工程已不再需。
若模型能协助定位特定行为、提出可验证干预,就可能缩短部分诊断与试验过程。它也可能与解释工具、传统优化和程序化评测结合,而不是只在现有方法之外单独工作。
不过,输出候选补丁与交付可靠改进之间,还隔着复现、回归、运行成本和安全审查。优化必须由独立的业务与测试指标衡量。
不能让提出补丁的同一个过程随意修改评测标准,再用自己的解释宣布成功。保留未参与选择的测试,固定预算与版本,记录失败和副作用,对重要任务增加独立复核。
改进某个指标时,也要核查其他能力是否下降。单项得分上升不能说明系统整体更可靠,更不能自动成为下一轮优化的信任基础。
可说它扩展了 AI 参与模型诊断和参数构造的方式。还不能说它证明了无限递归自我提升、通用大模型自动编译,或训练范式已被替代。承认研究意义与保留边界,可同时成立。