200元档二手手机怎么选?低预算备用机候选与验机
2026-11-06 3469131

2026-11-06 0
六倍变化来自被编辑的 Qwen3.5-0.8B,而非 Astra 自身能力突然倍增。MIT CSAIL 团队让 Astra 在受限工具与反馈下修改权重,重点改善重复推理、难以完成答案的行为。
Astra 获得权重、Python 环境和练习题,可进行有限次数的前向反馈;研究不允许它启动训练循环或利用梯度更新参数。练习使用训练集合,正式评测集合另行保留,二者不能混成“看着考试答案改模型”。
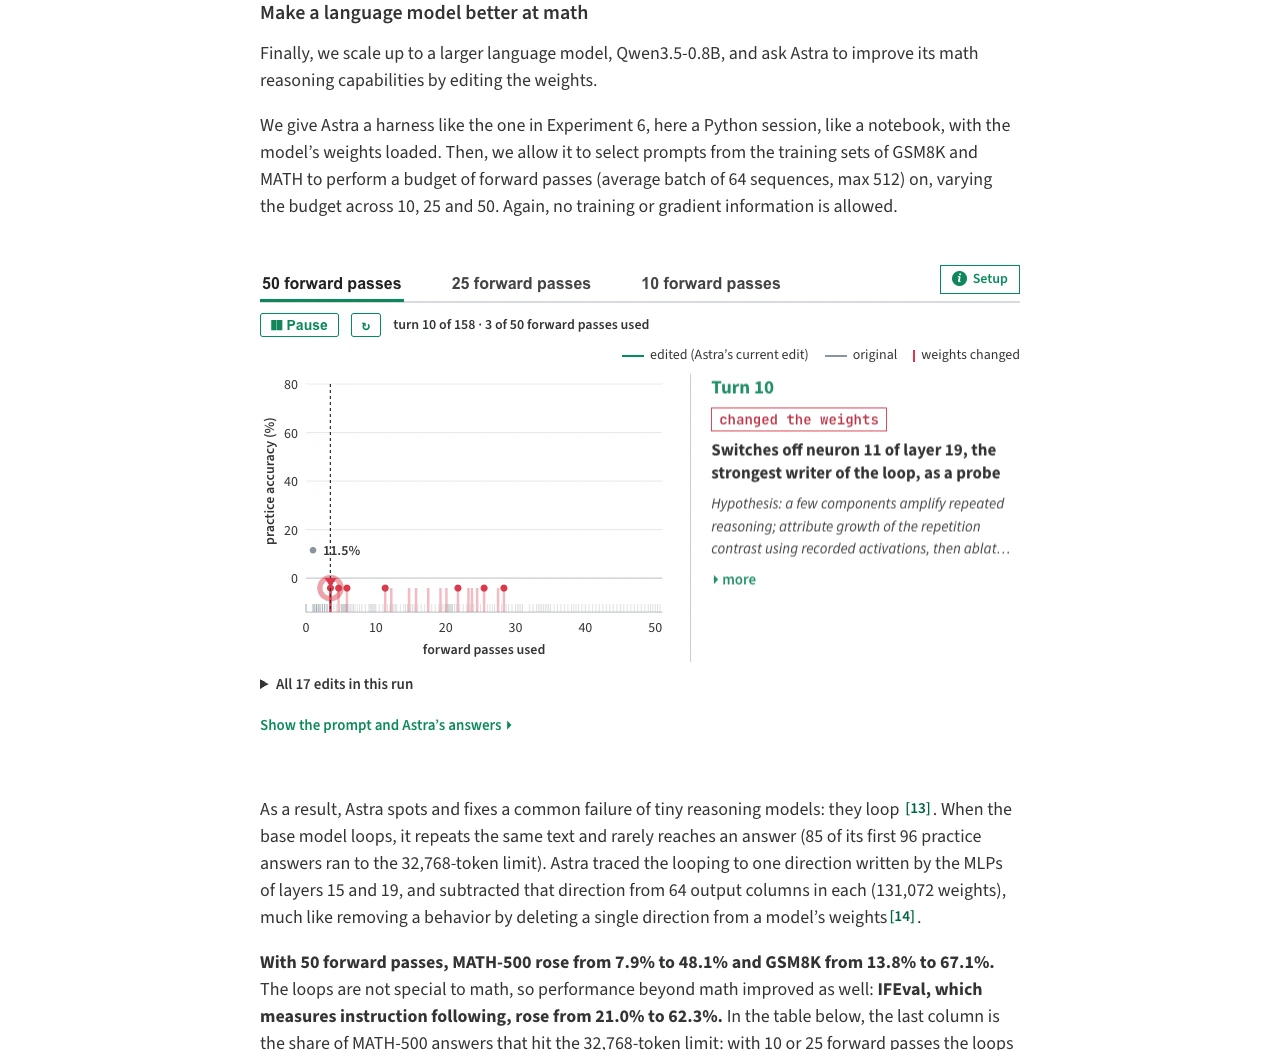
在报告中的 50 次前向反馈预算设置下,MATH-500 从 7.9% 提高到 48.1%。48.1 除以 7.9 约为 6.09,因而可说分数达到原来的约六倍;绝对增加的是 40.2 个百分点,而不是增加六个百分点。
这些数字对应规定的采样、输出上限和多次采样平均,不能拿来当作任意提示、任意部署的保证。前向反馈的一次调用可包含一批序列,也不是只做了五十道练习题。
小模型原先大量生成会陷入重复,耗尽输出预算仍没有完整答案。编辑降低了促成这种行为的部分权重方向,使更多问题能够结束推理、给出可评分结果。改善一个严重瓶颈,可能产生远大于参数比例的效果。
可类比一条道路上的关键堵点:疏通它能恢复已有通行能力,但不等于凭空修出六倍道路。这个类比解释的是瓶颈,不意味着神经网络等同于确定性程序。
研究还观察到指令遵循等表现改善,说明被抑制的循环不只影响数学输出。不过,有限评测不能证明所有任务都受益,也不能说明其他模型一定存在同样问题。
它是一个相应小模型、相应故障行为与相应工具配置下的实验。已有数学能力被循环遮挡,与给模型补充原本不会的推理是不同问题。对不以循环为主要失败原因的模型,同样方法未必有效。
更实际的启发,是把模型输出问题按原因分类:先判断失败来自知识、推理、格式还是无法终止,再决定是否需权重级修复,而不是看到大幅涨分就对所有模型复制补丁。