Gartner 说40%企业应用将嵌入 AI 智能体,和开放模型什么关系?应用智能体与模型选型的联系
2026-11-06 3469158

2026-11-06 0
4.4 个月描述的是特定评测与拟合方法下的能力追赶时间,并非整个行业固定的开放与闭源差距。Mozilla 使用 METR 数据进行相关估计;Epoch 则另有约四个月的综合能力分析。它们方法不同,也不是 Gartner 统一测得的一个数字。
METR 用一组任务衡量模型的完成能力,再以人类专家完成这些任务所需的时间表达难度。所谓 50% 时间跨度,是模型在这类难度的任务上大约有一半成功概率,并不是模型可连续稳定工作这么长时间。
Mozilla 将开放与闭源模型的相应表现随发布时间的变化进行拟合,再比较达到相近水平所对应的时间差,得到约 4.4 个月。它反映的是该样本、该指标和拟合方式下的追赶关系,不能把小数点当成精确到几天的行业事实。
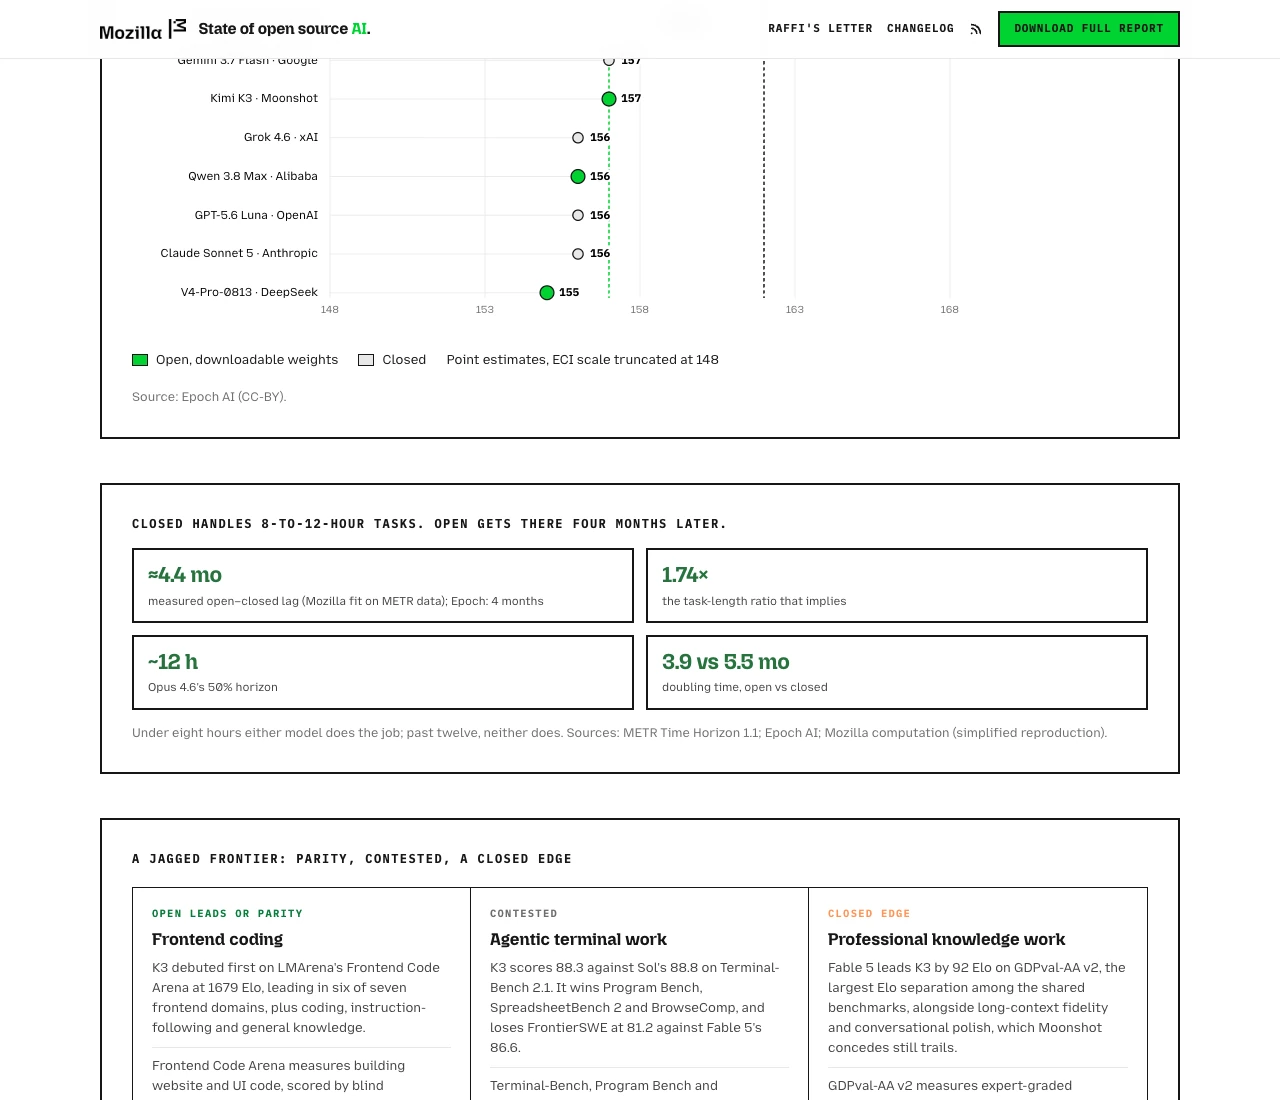
假设某个闭源模型在年初达到一项任务难度,而开放模型在之后几个月达到相近水平,这段时间就构成一次追赶间隔。研究把多项观察放在趋势中分析,可描述前沿能力如何推进;它并没有比较每一家企业的真实业务,也没有保证下一次发布仍保持相同间隔。
Epoch 的综合指数分析则使用另一套能力指标和模型样本。即便结果也接近四个月,仍然只是不同方法下出现相近数量级,不能把一个指数的分差直接换成另一个任务集的工作时长。
| 容易忽略的条件 | 会怎样影响结论 |
|---|---|
| 比较的是前沿模型 | 不代表所有大小、所有硬件上的模型 |
| 任务集不同 | 代码、长文、视觉与业务问答可能各有强弱 |
| 运行设置不同 | 工具、推理预算和上下文会改变表现 |
| 可靠性要求不同 | 一半成功与生产可接受的失败率差别很大 |
基准测试通常不会完整计入知识库维护、权限控制、网络延迟和人工返工。一个模型在公开题目中表现不错,可能仍不熟悉企业内部缩写;另一个模型分数略低,却能在固定提取任务里更快、更便宜地返回合格结果。
量化版本、上下文长度和并发也会改变表现。下载同一家族的小版本,不等于获得榜单中最大版本的能力。比较前应固定相应版本、提示、工具和预算,否则很难判断差异来自哪里。
它适合提醒企业持续评估开放模型,而不是永久沿用“能力差距太大”的印象。真正选型时,把自家历史任务分成普通、复杂和高后果三组,比较合格率、耗时、人工修改与每个合格结果的成本。能否满足业务门槛,比模型被称为领先或落后几个月更重要。