怎么防止AI改写弄错专业术语?从术语表到并排校对
2026-11-16 3469730

2026-11-16 0
检测一篇文章时,工具会根据文本给出对生成来源的估计。可以依次看模型从文字提取了什么信号、用什么样本学会分类,以及报告给出的分数在当前语种和文本场景下能说明什么。
有些方法先用语言模型给一段文字打分。例如,困惑度反映模型预测文本的难易,数值较低通常表示这段文字在该模型看来更容易预测。还有研究比较原文和若干轻微变动后的版本,观察模型给出的概率变化。不同方法关注的统计量不同。以 GPTZero 为例,它曾使用困惑度和文本波动指标,后来改用深度学习架构。
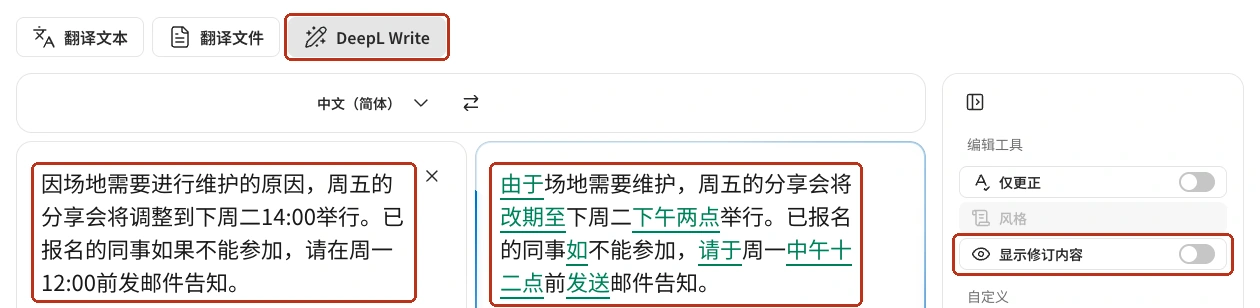
公文模板和设备操作说明经常使用相同句式。比如“请于周五下班前提交申请”这类通知用语很常见。即使出自人工,模型也很容易预测后面可能出现的词。
另一类方法使用已知来源的样本训练分类模型。模型接收一段文字,综合处理上下文,再输出分类或相应分数。例如,两篇稿子都用相同的小标题,模型仍可能因为前后文的差别给出不同结果。工具换了版本,或遇到训练样本覆盖较少的题材,结果也可能变化。
AI文本检测与查重回答的是两个问题。前者估计文字是否呈现机器生成的模式,后者在可检索的资料中寻找相同或相近的内容。一段从未公开的生成文本可能没有查重匹配,一句从公开手册原样引用的文字也可能来自人工撰写。
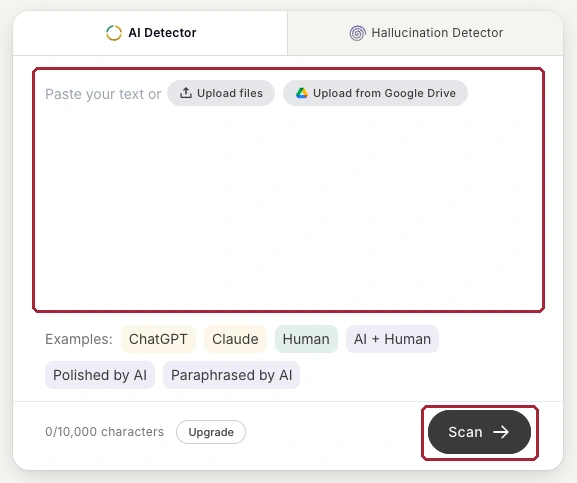
阅读报告前先核对语言、长度和分数定义。同一产品的检测和解释功能可能支持不同语言。例如,Copyleaks 的文本检测 API 支持简体和繁体中文,其短语级 AI Logic 解释功能目前只列出六种语言,中文不在其中。网页端和 API 的具体限制要按各自入口查看。
整篇分类、模型置信度和被标记文字占比各有含义。假如报告写的是“模型置信度”,这个数字表示模型对分类的把握,无法直接换算成有多少字由 AI 写成。一篇稿件包含人工访谈、文档引用和 AI 辅助改写时,还要区分各部分的写作过程。
报告标出可疑段落后,可以核对最初的提纲和修改记录,找到数字、引用和结论的出处。如果段落只说了空泛的评价,就按材料补上具体条件。需要申报 AI 辅助写作时,写清工具参与了哪些环节。