AI改写批量做还是逐篇做?从成稿质量和耗时比较
2026-11-17 3469849

2026-11-17 0
批量改写稿的二次加工从原稿对照开始。按编号找到对应文章,优先复核版本、数字、适用条件和结论,再调整段落顺序和标题。遇到功能入口或格式变化时,回到软件界面与原始记录核对,然后逐篇定稿。
先把原稿和改写稿分别整理成两份记录。文章编号 article_id 要唯一,同一篇保留相同编号,两份记录的字段名也要一致。例如保留最低适用版本 minimum_version 和导出格式 export_format。
稿件已经结构化时,可以用 n8n 的 Compare Datasets 节点找差异。把两组记录分别接到输入 A(原稿)和输入 B(改写稿)。在 Fields to Match 下,Input A Field 和 Input B Field 都填 article_id。将 When There Are Differences 设为 Include Both Versions,以便同时核对两版。
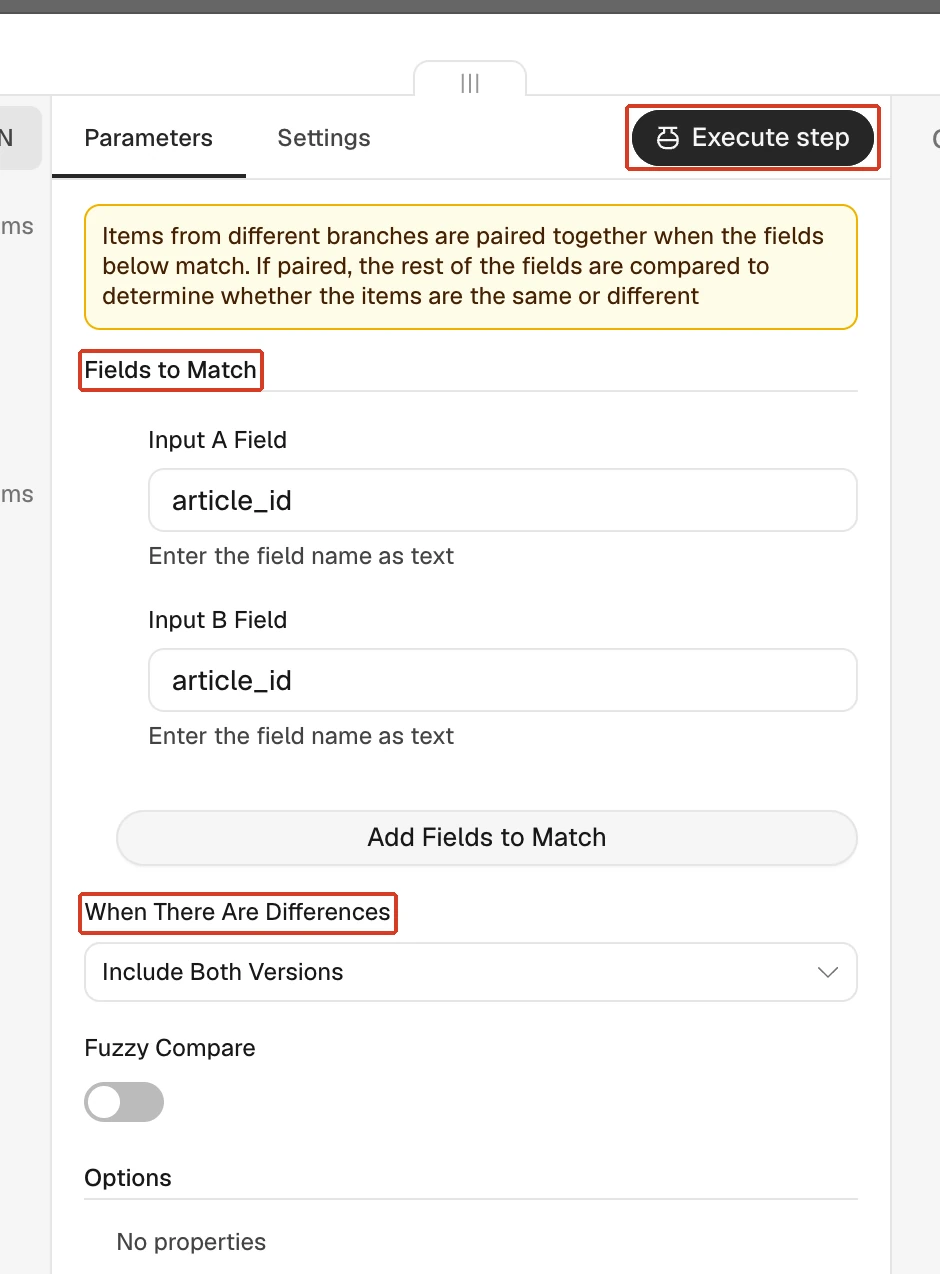
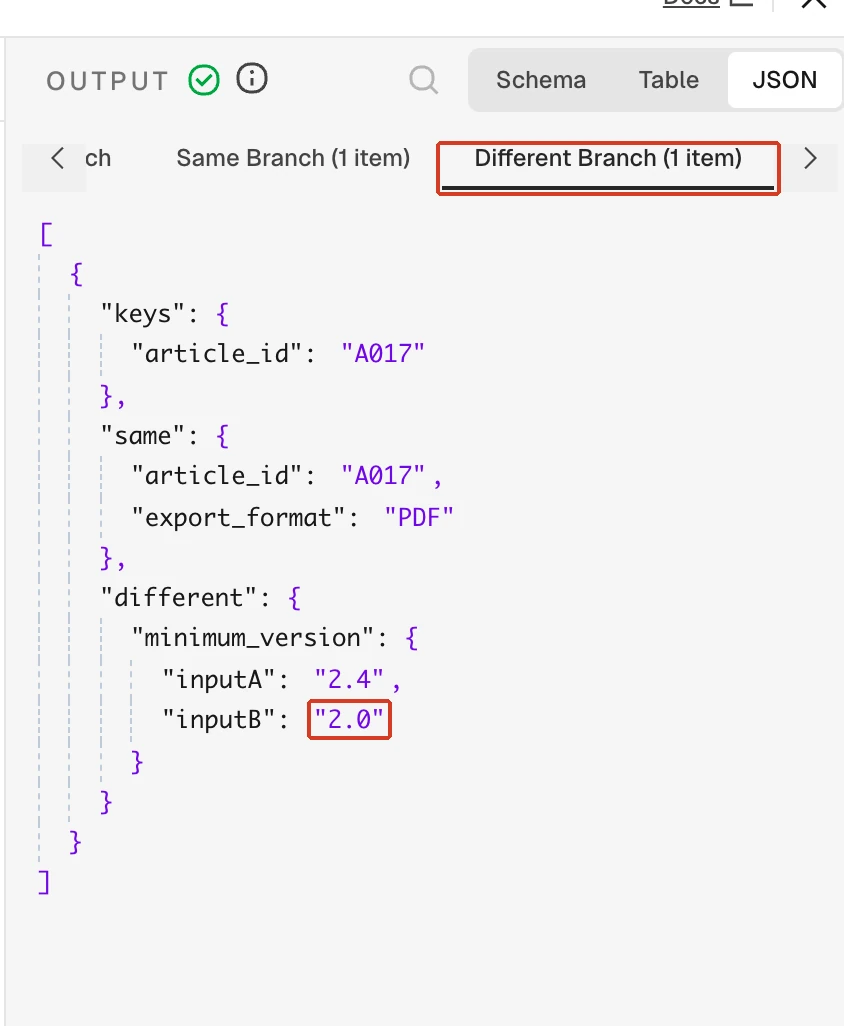
点击 Execute step 后打开 Different,选择 JSON。A017 的格式仍是 PDF,但最低适用版本由 2.4 改成 2.0。版本门槛变化会影响读者能否照做,先回到原资料核对,再决定新稿写哪个值。
In A only 和 In B only 可用来排查漏稿、新增稿或编号填错。Compare Datasets 依据输入字段值判断是否变化,编辑仍需结合原资料判断。若把整段正文送入比对,正常润色也会出现差异,建议先送入需要核对的事实字段。
给每篇稿件写一句直接回答标题的问题,再按读者会遇到的顺序摆放条件、操作和结果。可以通用的排版批量调整,截图与当前功能入口的对应关系逐篇检查。
再看一个例子。原稿只说“2.4 及以上版本可导出 PDF”,改写稿写成“2.0 版本可导出多种格式”。确认资料后,把开头写成“使用 2.4 或更新版本,可将文件导出为 PDF”,并清理正文里超出资料的承诺。差异清单可以留四列,分别记录编号、变化、核对依据和定稿结果。