Flutter 3.47.8 是什么版本?stable 稳定通道更新说明
2026-10-29 3468430
2026-10-29 0
想象一下,你寄送的重要快递被退回了,快递员不会直接丢弃,而是根据你的要求间隔几小时后重新投递,直到成功或达到最大投递次数。Apache DolphinScheduler的任务重试机制就是这种"智能重投"的调度系统版。
DolphinScheduler提供了完善的任务失败重试机制,支持业务任务节点在执行失败后自动延迟重试,直到成功或达到最大重试次数。该机制通过状态机驱动、事件发布和延迟队列实现,确保任务执行的可靠性。
当任务(如Shell脚本)执行失败时,系统会立即检查两个关键配置:
failRetryTimes:最多重试几次(默认0次)failRetryInterval:每次重试间隔几分钟这些配置在任务创建时设定,前端表单会将其转换为JSON格式存储。
系统不会立即重试,而是计算精确的延迟时间:
// 实际延迟 = 配置间隔 - (当前时间 - 任务结束时间)long remainingTime = TimeUnit.MINUTES.toMillis(delayTime) + System.currentTimeMillis() - taskInstance.getEndTime().getTime();这确保无论任务何时失败,都能保持固定的重试间隔。
重试过程由状态机精确控制:
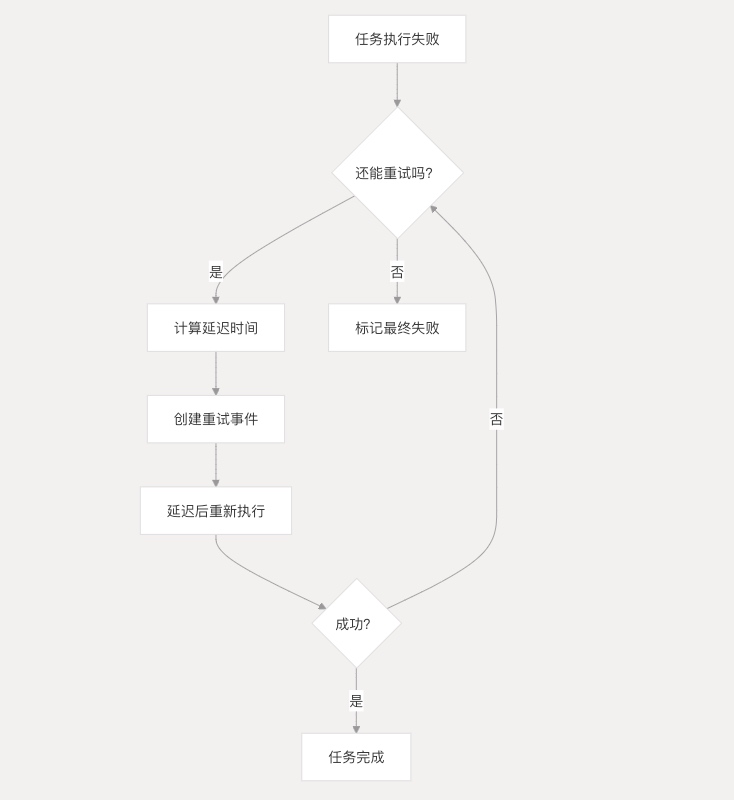
集成测试展示了完整的重试过程:
如果任务B依赖任务A,当A失败但未达最大重试次数时,B会进入等待状态而非直接失败 7 。
即使任务正在等待重试,你仍可以:
Apache DolphinScheduler的重试机制就像一个尽职的调度员,在任务失败时不会轻易放弃,而是按照你的要求智能地重新尝试。通过状态机精确控制、延迟计算和事件驱动架构,确保了分布式环境下任务执行的可靠性。记住:只有真正执行代码的业务节点才能享受这种"重投"服务,而逻辑节点则需要你手动处理异常情况。