平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“Oracle增量同步配置指南”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
适合:Oracle 上跑着老 ERP / 进销存,每天几千到几万条新单据,要同步到 MySQL、SQL Server 或另一个 Oracle
关键前提:单表 10–20 万行、分钟级延迟能够接受
为什么 Oracle 的同步比想象中麻烦
落到代码里,Oracle 在很多公司是「不能停的那台机器」。跑着十几年的 ERP,单据表几十万到几百万行,每天还在往里写。想把它和新系统打通,会遇到这么几个现实问题:
- 全量搬不动:几百万行走一遍,占用带宽、拖慢生产库,还常常跑一半断掉
- 只要变化的部分:今天新增 8000 条单据,你只需这 8000 条,不想重搬历史
- 改过的也要:不只是新增,昨天那张单子今天改了金额,也得跟过去
- 删掉的也得管:源库删了一条,目标库不知道,久了就对不上账
- 不敢乱动生产库:加字段、建触发器这类动作,在 Oracle 上要报审批
这套流程解决的就是这几件事。核心只有一个概念:变化识别字段。理解了它,剩下都是填空。
先厘清三个词,后面全靠它们
全量同步:把整张表从头搬一遍。
增量同步:只搬「上次同步之后」新增的和修改过的记录。
变化识别字段:程序靠哪个字段判断「这条记录是新的、或者被改过」。
打个比方:全量是把整个仓库盘点一遍,增量是只看今天入库和出库的单子。而「变化识别字段」就是那张单据上的时间戳——你得有个可靠的时间戳,才能知道哪些单据是今天的。
第一步:给 Oracle 账号把权限开对
Oracle 的权限体系有个特点,很多人第一次都会懵:落到代码里,若你用的账号就是这个 schema 的主人,你在权限视图里反而查不到自己表的授权记录落到代码里,。这不是没权限,是 Oracle 的机制——schema 主人对自有表天然有权限,不记录在授权视图里。
所以配账号时按需求给:
-- 1) 基础:读数据(必须)
GRANT SELECT ON ERP.订单主表 TO sync_reader;
GRANT SELECT ON ERP.订单明细 TO sync_reader;

-- 2) 增量需要(二选一,看你在第六步怎么选)
--    a. 用表里已有的时间字段 → 上面第 1 条就够了
--    b. 让程序加专用同步时间列 → 需要改表权限
GRANT ALTER ON ERP.订单主表 TO sync_reader;

-- 3) 删除同步需要(如果要用,见下面「删除怎么处理」)
GRANT CREATE TABLE TO sync_reader;   -- 建墓碑表
GRANT CREATE TRIGGER TO sync_reader; -- 建删除触发器
表多的时候别一条条写,让 DBA 跑个循环批量授权:
BEGIN
  FOR t IN (SELECT table_name FROM all_tables WHERE owner = 'ERP') LOOP
    EXECUTE IMMEDIATE 'GRANT SELECT ON ERP.' || t.table_name || ' TO sync_reader';
  END LOOP;
END;
/
一个实用的判断方法:别靠猜。在工具里点「测试连接」,它会真的去读数据字典验证权限,而不是只看连接通不通。连上了但没读权限,这一步就会明确告诉你差什么。
第二步:加数据源,看清版本号
「数据源」→「+ 新增数据源」→ 类型选 Oracle。
- 落到代码里,服务名/实例名那一栏,填的是
ORCL、FREEPDB1这类服务名,不是 SID(除非你们用的是 SID 连接方式) - 端口默认 1521
- 填完点「测试连接」
理解这一步时,连上后会显示 Oracle 的真实版本,比如 11.2.0.4 或 19.3。这个版本号要记住落到代码里,,因为 Oracle 不同大版本对应的 JDBC 驱动不一样,版本对不上会出现很奇怪的现象——连接正常、查询却报错,或者中文乱码。
从实现思路看,工具内置了驱动版本对照,版本不匹配时列表里会直接标红提示「低于官方兼容,建议换 xxx 版本」,点一下就能换,不用自己满网去找驱动文件。这一点对 Oracle 特别有用,11g 和 19c 的驱动混用是经典坑。
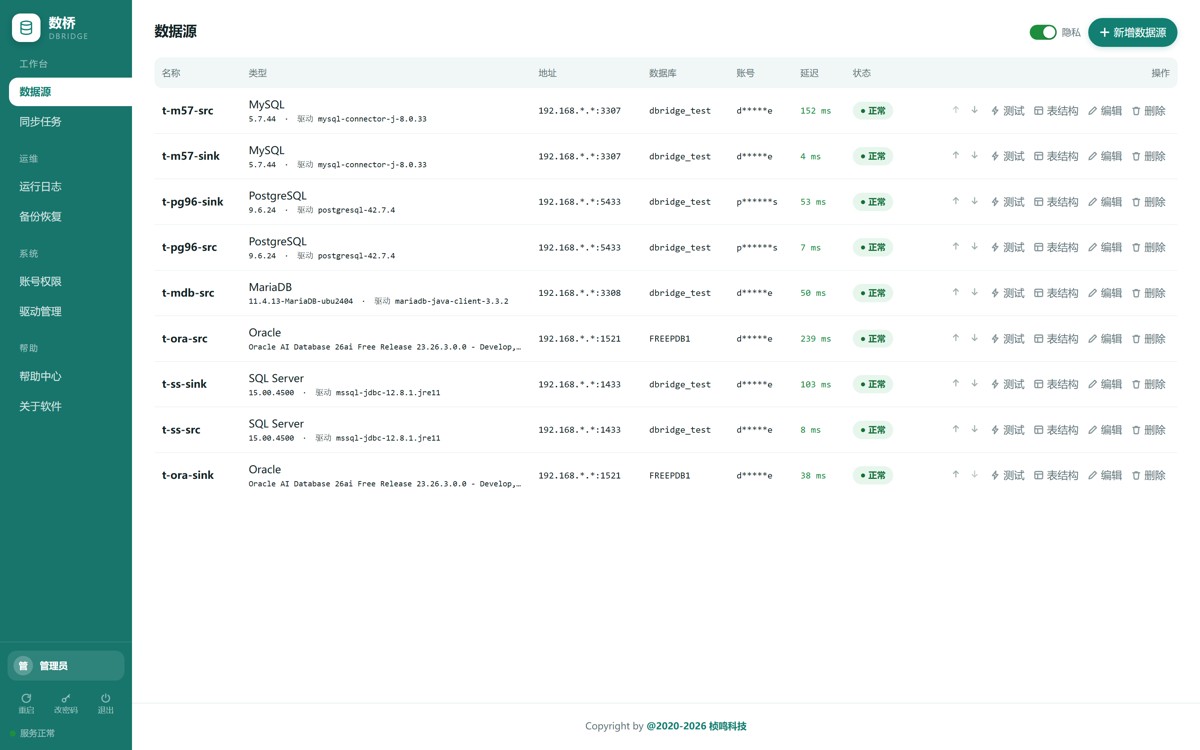
实际处理时,上面这些库都是用同一套流程加的。Oracle 那两行能直接看到真实版本号和驱动名,延迟 230ms 还是 20ms 也有记录——连不通和连得慢是两回事,这两列能分开判断
第三步:建任务组,一次配好所有表
「同步任务」→「+ 新建任务组」。
- 任务组名称:比如「ERP 单据同步」
- 源数据源:Oracle 那个库
- 目标数据源:MySQL / SQL Server / 另一个 Oracle
- 勾选表:搜索过滤后「勾选当前」批量勾,已选数量会显示
自动化选项里那两个默认勾着的建议保留:
- 目标库没有同名表时自动建表:Oracle 的
NUMBER、VARCHAR2、DATE会自动对应到目标库的类型 - 目标表缺字段时自动补建
下面就是最关键的一项。
第四步:选变化识别字段(决定成败)
三个选项,我按建议程度说:
选项一:智能建议(默认,也是我最建议的)
程序对每张表单独判断,优先级是:
- 有能自动维护的时间字段(比如 MySQL 的
ON UPDATE CURRENT_TIMESTAMP)→ 用它 - 字段名像更新时间的(
lastmodifytime、updatetime、gmt_modified这类)→ 用它 - 有任意时间类型字段 → 用它
- 理解这一步时,都没有 → 给这张表加一个专用列
zz_sync_time,程序自己维护 - 实在建不了(没权限)→ 这张表退化成每次全量
这个策略的好处是不用你逐表确认在这个场景下,,几十张表一次过。Oracle 老系统尤其适合,因为很多老表确实没有规范的更新字段,程序会自动给它们加 zz_sync_time。
注意:如果程序需往你表里加列,会先告诉你哪几张表要加。这一步会改生产库结构,必须先跟业务方确认。不想动表结构,就看下面选项三。
选项二:统一用系统专用字段
每张表都加一列 zz_sync_time,程序在每次写入时自动维护。
什么时候选它:表结构乱得没法判断、或者你希望所有表行为完全一致、便于以后排查。
代价是:要改所有源表的结构在这个场景下,。Oracle 上加列一般是秒级完成(加可空列不重写表),但仍然要走变更流程。
选项三:用我指定的字段名
结合项目来看,比如你们规范里所有业务表都有 lastmodifytime。填进这个框,程序会在每张表里找这个字段:有就用,没有就按这个名字建一个。
从实现思路看,这个选项适合「有规范但规范执行得不彻底」的情况——大部分表有,少数老表没有,程序会自动补上。
三个选项共同的铁律
变化识别字段必须是「每次修改都会更新」的字段。
反面教材,请务必避开:
| 不能用的字段 | 为什么 |
|---|---|
| 自增 ID / 主键序列 | 修改记录时它不变,改了数据永远同步不过去 |
| 新建时间(created_at) | 同上,它是入库时间,不是修改时间 |
| 业务日期(单据日期) | 会倒填、会补录,顺序完全不可靠 |
在这个场景下,这类字段当变化识别字段,结果是「同步一直显示成功,但目标库数据是旧的」。它不报错,这是最坑的地方——你可能一个月后才发现对不上账。
第五步:频率怎么定,第一次要跑全量
第一次运行一定是全量,因为程序没有任何历史进度可参考。所以:
- 第一次安排在夜里或维护窗口,别在白天业务高峰跑
- 第一次跑完,看看耗时记下来,作为后续估时的基准
- 从第二次开始才是增量
频率填 cron 表达式,六位:秒 分 时 日 月 周。
每 10 分钟   0 */10 * * * ?
每小时整点   0 0 * * * ?
每天凌晨 2 点 0 0 2 * * ?
每天早 7 点   0 0 7 * * ?      ← 上班前跑完,最适合给报表用
频率属于任务组,组内所有表共用这个节奏,改一处全组生效。
频率别设太密。经验值:单表 10 万行大约 15–20 秒(Oracle 到 MySQL 实测 16.8 秒),但如果目标库是 SQL Server,同样 10 万行要 48.9 秒。上一次还没跑完下一次又到点,会排队等着,反而更慢。
第六步:删除怎么处理(这段最多人漏掉)
增量同步天然只管「新增和修改」,删除是另一件事落到代码里,。源库删了一条记录,增量逻辑看不到——那条记录只是「不再出现」,不是「出现了变化」。
处理办法是:程序在源库建一张墓碑表和删除触发器在这个场景下,,源表上每删一条,就往墓碑表里记一笔(主键值 + 删除时间),同步时再按墓碑表去目标库删对应行。表有主键就自动开这个功能。
这里有个必须知道的限制:建触发器需权限,不是所有环境都给得了。
- Oracle 源库:账号需
CREATE TRIGGER。很多公司的 Oracle 账号拿不到这个权限,需 DBA 代建或者走变更。 - MySQL 源库(常用于云数据库):如果开启了 binlog 且
log_bin_trust_function_creators = OFF(云 RDS 默认就是 OFF),普通账号建触发器会报 ERROR 1419,提示缺少 SUPER 权限。这种情况下墓碑表能建、触发器建不上。
重点来了:好的工具在这种情况下会明确告诉你「删除同步不可用」结合项目来看,,而不是显示「已启用」随后静默失效。我们早期版本就吃过这个亏——界面上看着是开了,实际上源端删的数据从来没传到目标端,客户过了两周才发现目标库留了一堆孤儿行。
结合项目来看,所以配完删除同步,一定去界面上确认它的状态是真启用,不是「假装启用」。拿不准就先手工删一条测试数据,看目标库那边会不会跟着少一行。
第七步:同步成功但数据没变?看那个琥珀色叹号
这是增量同步最隐蔽的故障,单独拿一节讲。
现象:任务明细里状态是「成功」,进度也走完了,但目标库的数据是旧的。
程序对这种情况有个专门的检查——连续 3 次同步一行新数据都没读到,而目标表仍然比源表少行,就在状态列标一个琥珀色叹号落到代码里,(叫「进度停滞」)。鼠标停在上面能看到:连续几次、差多少行、从什么时候开始的。
三个最常用的成因:
1. 变化识别字段挑了个不会更新的列
在这个场景下,就是第四步说的,自增 ID、新建时间。改完设置后再跑一次,读到数据了,叹号会自己消失,不用手工清。
2. 数据里混进了「未来的时间」
结合项目来看,如果源库里有些记录的更新时间被写成了 2099 年(历史数据迁移时常用的脏数据),那它永远在「上次同步到的位置」之后,永远读不到。这种情况得先把脏数据的字段值改回正常。
3. 目标表缺行但没配主键
在这个场景下,程序在自动补齐缺失行时,需主键来定位「哪几行缺了」。没主键它不敢动手——因为可能删错数据。这种要给表加主键,或者接受它不自动补。
第八步:换字段会重置进度,别在高峰做
若后面发现字段选错了,回任务组里改「变化识别字段」,要知道两件事:
- 组内所有表的进度会被重置,下次运行会整表重新扫一遍
- 结合项目来看,重新扫不会导致数据重复(程序按主键做覆盖式写入,重复跑同一批数据不会变成两倍),但这一次会慢
所以改字段安排在夜里。改完盯一次运行,确认耗时和行数正常。
实测数据
单表 10 万行,局域网,程序和数据库同机(2 核 4G):
| 同步方向 | 耗时 |
|---|---|
| Oracle → MySQL | 16.8 秒 |
| Oracle → SQL Server | 48.9 秒(最慢组合) |
| MySQL → Oracle | 17.9 秒 |
- 读写行数都是 100,000 / 100,000,逐行核对过结果
- 落到代码里,增量同步的实际耗时取决于「这一轮有多少条变化」,不是表的总行数。一天 8000 条变化,通常几秒就完
- 在这个场景下,机器负载影响明显,同一套条件在更空闲时测得 7.8 秒,所以对外按「10 万行 15–20 秒」估最稳
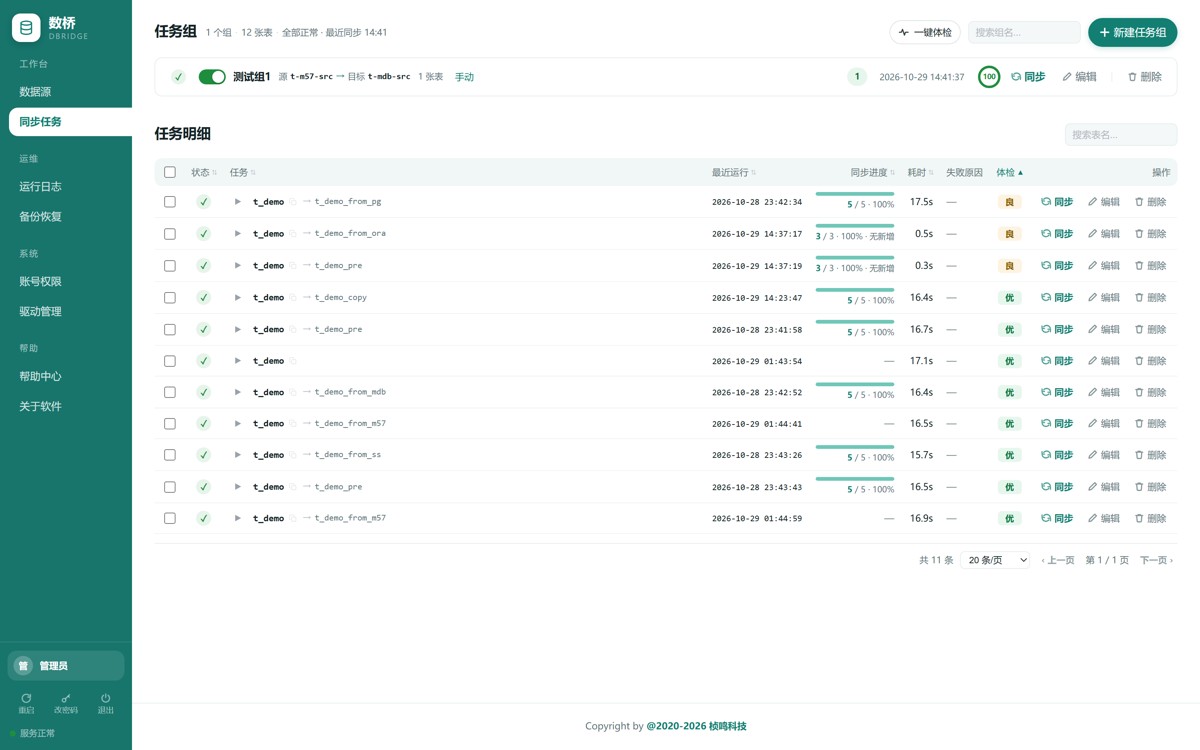
跑完先看这三列:进度是不是 5/5 - 100%,耗时有没有异常放大,体检理解这一步时,是优/良/中/差哪一档。「无新增」表示这一轮一条变化都没读到,是正常状态,不是失败
一套完整的检查清单
上线前照着过一遍,能避掉大部分事故:
- 从实现思路看,源库账号有 SELECT,需加列的有 ALTER,需删除同步的有 CREATE TRIGGER
- Oracle 版本号和驱动版本匹配(界面标红就换)
- 变化识别字段不是自增 ID、不是新建时间、不是业务日期
- 点过「预览每张表会怎么识别新数据」,结果给业务方看过
- 要改表结构(加
zz_sync_time)的,已经跟业务方确认 - 第一次跑安排在非高峰时段
- 跑完做过一次行数核对
- 删除同步的状态是真启用,不是「假装启用」
- 目标库和源库的字符集/排序规则一致(中文乱码的根源)
- 频率设得比单次耗时留够余量(至少 3 倍)
这套方案不适合的场景
说实话,工具都有边界。下面这些别硬套:
- 要求秒级实时:需 CDC(变更数据捕获)那类方案,这套是分钟级/小时级
- 单表百万行以上:不在目标场景内,大表迁移建议分批或者用专门的迁移工具
- 要同步存储过程、视图、触发器、序列:目前只同步表的结构和数据
- 源库不能被改任何结构:连加一个可空列都不行的话,只能选「用指定字段」,而指定字段必须你自己保证它会随修改更新
理解这一步时,如果你要的就是「每天把 Oracle 的新单据可靠地搬到 MySQL / SQL Server」,这套是够的。免费试用 30 天,不用申请授权就能配任务跑起来。
落到代码里,配的时候卡住,把「体检」的报告截图发过来——它会直接把「缺什么权限、哪个字段类型对不上」写成人话,比翻日志快得多。
落到代码里,总的来说,Oracle增量同步设置适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。