权重可读可写,模型安全会有什么新风险?版本完整性和运行控制
2026-11-06 3469112

2026-11-06 0
模型横评应统一题集、版本和推理配置,再一起比较成本与时间。Astra 的高难数学表现突出,但其他模型可能更适合某些任务,单张榜单不能决定全部场景。
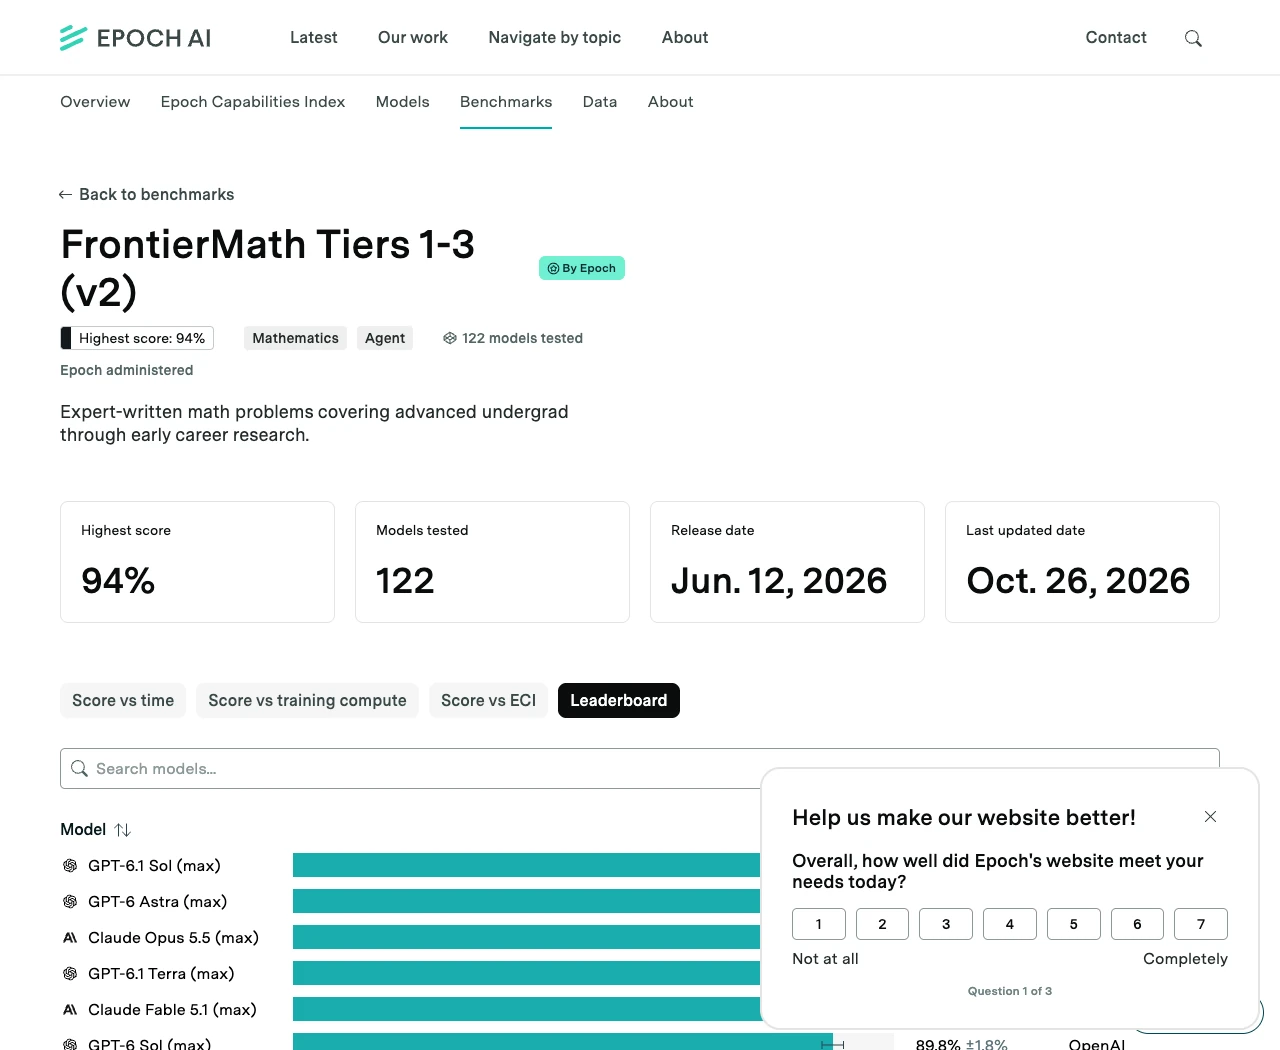
以下采用 FrontierMath Tiers 1–3(v2)中相应 max 配置的公开成绩。同一时期候选不宜求品牌版本号相同,表格也不能说明每个模型在所有任务中的排序。
| 模型 | 成绩 | 解读 |
|---|---|---|
| GPT-6 Astra | 93.7% ±1.4% | 该组中的高分候选 |
| GPT-6.1 Sol | 93.7% ±1.4% | 相同展示分数不等于行为完全一样 |
| Claude Opus 5.5 | 91.2% ±1.7% | 保留不确定性,不能只看小差值 |
| Claude Fable 5.1 | 90.2% ±1.8% | 需要结合实际任务与预算 |
| GPT-6 Sol | 89.8% ±1.8% | 不能脱离运行条件比较体验 |
文字题、竞赛题、长证明、形式化证明与开放研究,各有不同要求。一个模型善于提出思路,另一个可能更适合核实计算或调用工具。应把任务拆开,而不是只设置一项总分。
Tier 4 与 Tiers 1–3 使用不同题集,不能将两表数值相减解释成能力增减。旧版本成绩也不应混入新版本评测做趋势判断。
相同题目限定同样工具、预算和重试规则,记录成功结果的总耗时与费用。只比较单次 token 价格,会忽略推理长度、失败重试与人工复核;只比较最高分,也可能选到不适合日常负载的配置。
若业务只需基础计算,传统程序和校验规则可能已足够,不必每次调用最高能力模型。
要求模型写明条件、关键依据与可核查步骤,再用独立计算或专家复核。数学答案正确但论证不成立,仍不适合直接用于教学或研究。对形式化证明,要按验证器结果而不是自然语言自评判断。
选一批与你的工作相近的题目,保留简单、复杂、歧义和边界情况。分别统计第一次正确、需提示次数与复核负担,再决定哪些任务交给哪种模型。
Astra 的强项值得利用,但“最强”不等于所有任务都最省成本。选型结果应落到相应模型配置与工作流程,而不是长期固定一个总冠军标签。