权重可读可写,模型安全会有什么新风险?版本完整性和运行控制
2026-11-06 3469112

2026-11-06 0
这次结果更接近排除严重行为障碍,让 Qwen 原有能力得以表现,而不是获得六倍数学知识。称为修 bug 有助于理解,但它不是传统程序中某行语句写错那么简单。
一个模型可能已推到了有用思路,却因为循环和无法结束而交不出答案。评测只看到最终失败。减少这种行为后,更多回答进入可评分状态,正确率上升并不宜求模型新学会同样比例的数学方法。
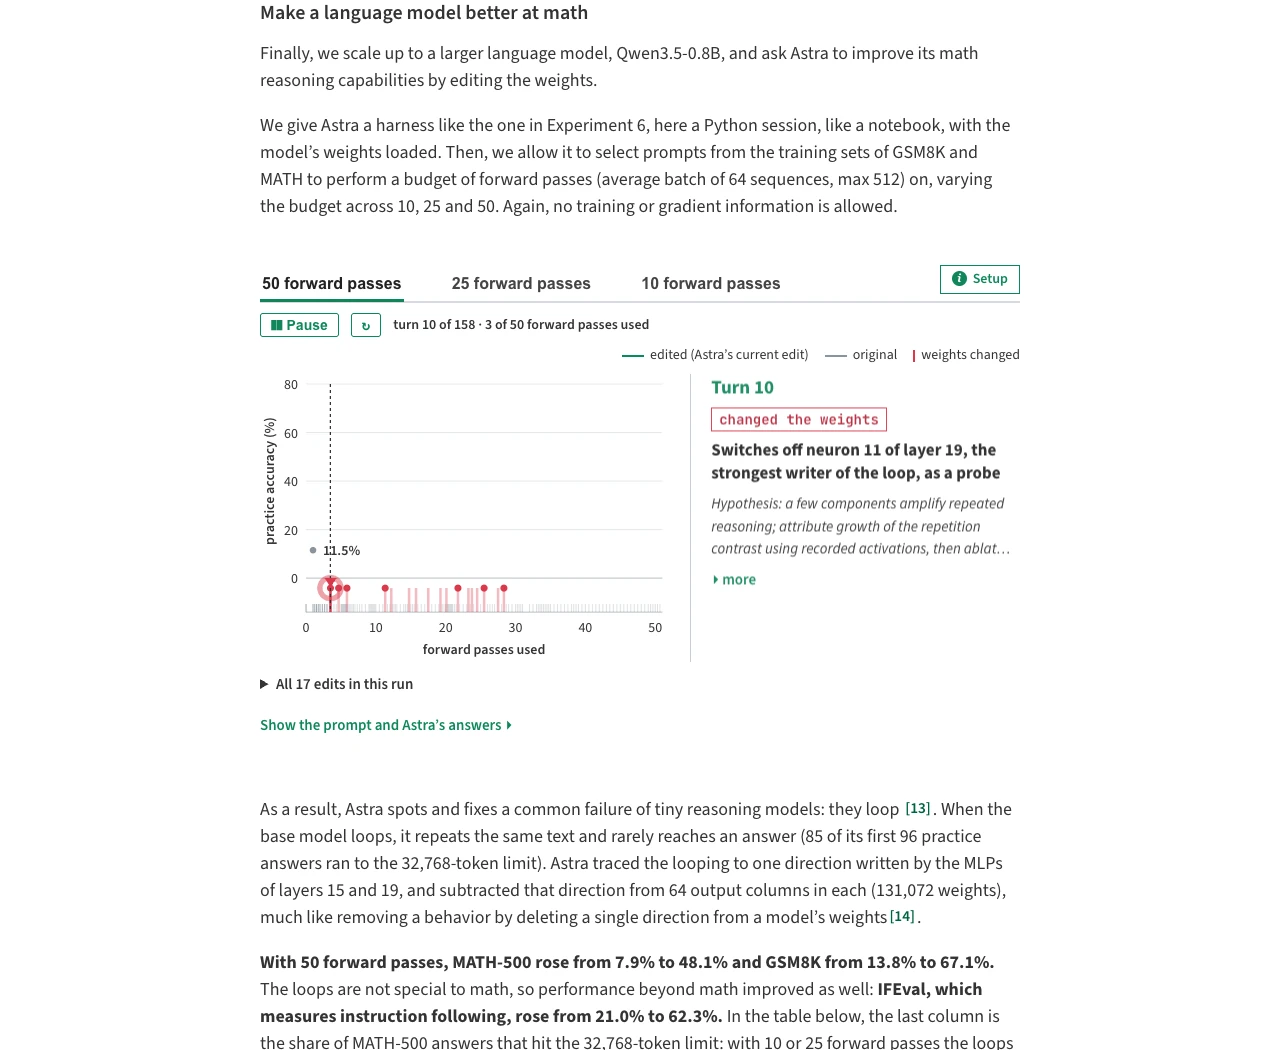
可同时看原模型的失败类型、编辑后的输出与其他任务。若主要变化是重复减少、答案完成率提高,而原先推理本身就有正确部分,更支持瓶颈修复的解释。若模型开始稳定解决原来完全缺乏方法的新题型,则需更充分证据。
这两种情况也不是绝对互斥。内部行为改变可能带来复杂影响,不能只凭最终分数就完整解释网络机制。
对另一个较少循环的小模型,实验没有获得明确的数学改进。它的错误更接近算术和推导本身,而不是同一种输出障碍。这说明成功补丁具有条件,不能直接推广为任意模型都能通过少量编辑显著涨分。
这并不否定 Qwen 修复的价值。能够定位一个跨许多题目反复出现的问题,本身就是有用的模型诊断能力,只是它与创造通用推理能力需分开评价。
传统故障通常有明确规范与局部代码;神经网络中的循环是参数、推理设置和输入共同作用的行为。将它定位到可编辑结构并验证改善,并不是自动完成的小事。
不过,也不应因而把实验升级成无限自我进化的证明。修改对象、任务与预算都受控制,后续还有扩展和复现问题。
这些指标比“聪明六倍”更接近工程价值。若修复能稳定减少失败、保持其他任务质量,它就可能有实际收益;若只能在单一配置下改善一个分数,部署仍需更谨慎。
评价这项工作,可同时承认方法有新意与结果有边界,而不必在“重大突破”和“毫无意义”之间二选一。